
監修:ZEN AI LAB(ZEN)
人間1人とAI社員で動く会社です。記事の数値は自社の作業ログの実測、仕様や料金は公式の一次情報で確認しています。確認した日付は本文に書いています。
レースのデータを手に入れて Python で数えたい、機械学習も試したいのに、どの表をどうつなげばいいか分からず止まっている方向けの記事です。
1号艇の1着率は、SQL(データベースから行を取り出す命令)で「1行=1艇」の表を作って数えます。pandas の groupby(グループごとにまとめる機能)を使えば数行です。機械学習に進む前に気をつけることは2つで、レースのあとで分かる列を外すことと、学習と評価を日付で分けることです。
この記事で分かることは、次の3つです。
- SQLite のデータを読み取り専用で開き、中身を確かめるコード
- 1号艇の1着率を、全体・場ごと・月ごとに出すコード
- 機械学習の2つの落とし穴を、小さなモデルで実際に試した結果
コードは、ZEN の研究用データベース(21万600レース)ですべて実際に動かし、出力をそのまま載せています。BoatData で集めた SQLite なら、表の形が同じなので、同じコードを自分のデータで動かせます。
競艇のデータで何が数えられるかの全体は、競艇のデータの見方と集め方にまとめています。
用意するもの: Python・pandas と、SQLite のデータ
使ったのは Python 3.13.1、pandas 3.0.3、scikit-learn 1.9.0 です。scikit-learn は機械学習の節でだけ使います。
データは、ZEN BOAT LAB の研究用データベースです。自社ツールの BoatData Collector Pro で集めたもので、1つの SQLite ファイルに入っています。SQLite は、ファイル1つで動くデータベースです。Python に最初から入っている sqlite3 で開けます。
BoatData を使っている場合の保存先は、ソースコードでは次のファイルです(初期設定の場合)。
%LOCALAPPDATA%\BoatData Collector Pro\data\db\boatdata.sqlite3
開くときは、アプリを閉じてからにしてください。
CSV で持っている場合は、そのままでは動きません。列の名前が違うからです(たとえば着順は finish_position)。払戻と欠場で絞る条件も、艇ごとの CSV だけでは同じにできないので、数字が少し変わります。CSV では試していません。エクセルで数えたい方は、競艇のデータ分析をエクセルでを見てください。
1. SQLite は読み取り専用で開き、中身の件数を見る
最初に、ファイルを読み取り専用で開きます。mode=ro を付けると、うっかり書き換えるコードを書いても、ファイルは変わりません。
import sqlite3
import pandas as pd

DB = "research.sqlite3"  # 自分の SQLite ファイルの場所に書き換える
con = sqlite3.connect(f"file:{DB}?mode=ro", uri=True)  # 読み取り専用で開く

tables = pd.read_sql("SELECT name FROM sqlite_master WHERE type='table'", con)
print(len(tables), "tables")
for t in ["races", "race_entries", "race_results", "payouts"]:
    n = con.execute(f"SELECT COUNT(*) FROM {t}").fetchone()[0]
    print(t, n)
出力です。
25 tables
races 210600
race_entries 1263600
race_results 1263600
payouts 2075656
races がレースの表、race_entries が出走表(1行=1艇)、race_results が結果(1行=1艇)、payouts が払戻です。出走表と結果は、レース数のちょうど6倍の行があります。
期間も見ておきます。
span = pd.read_sql("""
SELECT MIN(race_date) AS first, MAX(race_date) AS last,
       COUNT(DISTINCT race_date) AS days, COUNT(*) AS races
FROM races
""", con)
print(span.to_string(index=False))
first last days races
2023-01-01 2026-09-27 1366 2106002023年1月1日から2026年9月27日までの1,366日で、21万600レースです。
2. 1号艇の1着率は、SQL で絞ってから pandas で数える
この記事の「勝率」は、1着率(1着の回数÷レース数)のことです。選手の成績の指標の「全国勝率」とは別のものです。
1号艇の1着率を出します。数える対象は、2023〜24年のレースです。
DEV = """
r.race_date BETWEEN '2023-01-01' AND '2024-12-31'
AND EXISTS (SELECT 1 FROM payouts p WHERE p.race_id = r.race_id
            AND p.bet_type = 'trifecta' AND p.payout_status = 'NORMAL')
AND NOT EXISTS (SELECT 1 FROM race_results x WHERE x.race_id = r.race_id
                AND x.finish_status_code = 16)
"""
boat1 = pd.read_sql(f"""
SELECT r.race_id, r.race_date, r.venue_name,
       res.finish_position_numeric AS finish
FROM races r
JOIN race_results res ON res.race_id = r.race_id AND res.boat_number = 1
WHERE {DEV}
""", con)
boat1["win"] = boat1["finish"].eq(1)  # 着順が空(失格など)は False
print(len(boat1), "races")
print(round(boat1["win"].mean() * 100, 1), "%")
109188 races
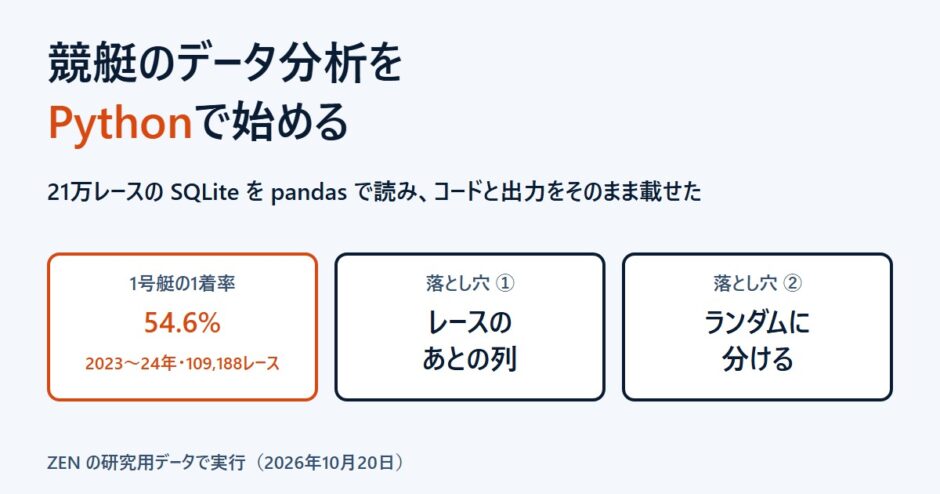
54.6 %2023〜24年の109,188レースで、1号艇の1着率は54.6%でした。
SQL の WHERE の中で、2つの条件を付けています。
- 3連単の払戻が成立したレースだけにする(payout_status が NORMAL)
- 欠場の艇がいたレースを除く(finish_status_code が 16 の艇がいない)
この条件は、無料で公開している1号艇の着順の記事と同じです。件数も1着率も、その記事の値と同じになりました。
失格やフライングで着順が付かなかった1号艇は、finish が空です。eq(1) は空の行を False にするので、「1着ではなかった」側に数えます。この記事の対象では、1,359レースがそうでした。
条件を付けないと数字が変わることは、エクセルの記事で試しています。何を分母に入れたかは、数字といっしょに書いておきます。
3. 場ごと・月ごとは、groupby の列を変えるだけ
場ごとにするには、groupby に場の名前の列を渡します。
by_venue = boat1.groupby("venue_name")["win"].agg(races="size", rate="mean")
print(by_venue.shape)  # 24 場 × 2 列(races と rate)
print(by_venue["races"].agg(["min", "max"]))
# print(by_venue)  # 場ごとの率は自分の画面で見る
(24, 2)
min 4045
max 4821
Name: races, dtype: int6424場で、1場あたり4,045〜4,821レースです。print(by_venue) を動かすと、自分の画面に場ごとの1着率が24行で出ます。
場ごとの1着率の一覧は、記事には載せていません。ZEN の有料の研究記事でまとめている中身だからです。コードは同じなので、自分のデータで動かしてみてください。
月ごとにするには、日付の先頭7文字(2023-01 の形)で分けます。
boat1["month"] = boat1["race_date"].str[:7]
by_month = boat1.groupby("month")["win"].agg(races="size", rate="mean")
by_month["rate"] = (by_month["rate"] * 100).round(1)
print(len(by_month), "months")
print(by_month.head(6))
print("min", by_month["rate"].idxmin(), by_month["rate"].min())
print("max", by_month["rate"].idxmax(), by_month["rate"].max())
24 months
races rate
month
2023-01 4975 56.3
2023-02 4180 55.3
2023-03 4590 57.2
2023-04 4461 54.1
2023-05 4719 56.2
2023-06 4692 54.8
min 2023-08 51.7
max 2023-03 57.22023〜24年の24か月で、いちばん低かったのは2023年8月の51.7%、高かったのは2023年3月の57.2%でした。
月ごとに見るときは、races の列(レース数)もいっしょに見ます。レース数の少ない月の率は、たまたま上下しやすいからです。
ここまでの数字は、過去のレースを数えたものです。この先の結果を約束するものではありません。
1,366日ぶんを集めるには、時間がかかる
数えるコードは短くても、データを集めるのはひと仕事です。BoatData の開発時の試験では、2026年8月の1か月・24場・4,944レースの取得に390.7秒かかりました。公式の公開データを自分で取る方法は、競艇の過去データをダウンロードする方法に書いています。
集めて SQLite にためるところを任せたい方には、ZEN の自社ツール BoatData Collector Pro があります。くわしくは記事の最後に書きます。
4. 機械学習の前に: レースのあとで分かる列を外す
ここからは、機械学習を試すときの落とし穴です。
1つ目の落とし穴は、レースが終わってから分かる列を、特徴量(モデルに渡す列)に入れてしまうことです。「未来の情報の混入」や「リーク」と呼ばれます。
レース前の列だけのビューから始める
研究用データベースには、レース前に分かる列だけを集めたビュー(保存された SQL)の vw_pre_race_features があります。出力用の vw_export_long_full と列を比べました。
pre = set(pd.read_sql("SELECT * FROM vw_pre_race_features LIMIT 0", con).columns)
full = set(pd.read_sql("SELECT * FROM vw_export_long_full LIMIT 0", con).columns)
print(len(pre), "columns (pre-race view)")
print(len(full), "columns (export view)")
after = [c for c in sorted(full) if c.startswith(("actual", "finish", "winning", "is_"))]
print(after)
51 columns (pre-race view)
99 columns (export view)
['actual_course', 'actual_st', 'actual_st_raw', 'finish_position_numeric', 'finish_position_raw', 'finish_status_code', 'finish_status_name', 'is_absent', 'is_capsized', 'is_disqualified', 'is_engine_stop', 'is_fallen', 'is_flying', 'is_late', 'is_non_finish', 'is_obstruction', 'is_refunded_boat', 'winning_technique_code_raw', 'winning_technique_mapping_status', 'winning_technique_name']レース前のビューは51列、出力用のビューは99列です。上の20列は出力用にだけある列で、どれもレースのあとで分かります。
- actual_course: 実際に入ったコース。展示の進入とは別です
- actual_st: 実際のスタートタイミング。展示のスタートタイミング(preview_st)とは別です
- finish_〜: 着順。is_〜 はフライング・失格などの印です
- winning_technique_〜: 決まり手
名前で見分けにくい列もあります。気象です。BoatData が書き出す表の weather・wind_speed・wave_height などは、レース時の記録のほうです。結果と同じところから取る値なので、レースが終わるまで分かりません(ソースコードと開発資料で確かめました)。直前情報の気象は、レース前のビューの preview_wind_speed_m などの列にあります。直前情報の展示タイムの順位ごとに1着の割合を数えた例は、競艇の展示データの見方にあります。
2つがどれくらい違うかを数えました。
wind = pd.read_sql("""
SELECT a.wind_speed_m AS preview_wind, b.wind_speed_m AS race_wind
FROM race_weather a
JOIN race_weather b ON b.race_id = a.race_id AND b.phase = 'RACE'
JOIN races r ON r.race_id = a.race_id
WHERE a.phase = 'PREVIEW'
  AND r.race_date BETWEEN '2023-01-01' AND '2024-12-31'
  AND a.wind_speed_m IS NOT NULL AND b.wind_speed_m IS NOT NULL
""", con)
print(len(wind), "races")
print(round((wind["preview_wind"] != wind["race_wind"]).mean() * 100, 1), "% differ")
110758 races
52.9 % differ直前情報とレース時で、風速の値が違ったレースは52.9%ありました。 1mだけの違いも含みます。2m以上違ったのは15.1%でした。同じ「風速」でも、どちらの時点の値かで中身が違います。
進入も見ておきます。
course = pd.read_sql(f"""
SELECT res.actual_course
FROM races r
JOIN race_results res ON res.race_id = r.race_id AND res.boat_number = 1
WHERE {DEV} AND res.actual_course IS NOT NULL
""", con)
print(len(course), "races")
print(round((course["actual_course"] != 1).mean() * 100, 1), "% not course 1")
109181 races
0.9 % not course 11号艇が1コース以外から出たレースは0.9%でした。少ないですが、実際の進入はレースが始まるまで分かりません。
レースのあとの列を入れると、見かけの成績が上がった
実際に、小さなモデルで比べました。その艇が1着になる確率を出す、ロジスティック回帰という単純なモデルです。2024年6月までで学習し、2024年7月からの半年で成績を測ります。
d = pd.read_sql(f"""
SELECT r.race_id, r.race_date, e.boat_number,
       e.racer_registration_number AS racer,
       e.national_win_rate, e.motor_top2_rate, p.exhibition_time,
       res.actual_st, res.actual_course,
       COALESCE(res.finish_position_numeric, 0) = 1 AS win
FROM races r
JOIN race_entries e ON e.race_id = r.race_id
JOIN previews p ON p.race_id = e.race_id AND p.boat_number = e.boat_number
JOIN race_results res ON res.race_id = e.race_id AND res.boat_number = e.boat_number
WHERE {DEV}
""", con).dropna()
train = d[d["race_date"] <= "2024-06-30"]  # 前: 学習
test = d[d["race_date"] >= "2024-07-01"]   # 後: 評価
print(len(d), "rows /", len(train), "train /", len(test), "test")
655066 rows / 492021 train / 163045 testfrom sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, log_loss
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
def fit_score(train, test, cols, cats):
Xtr = pd.get_dummies(train[cols], columns=cats, dtype=float)
Xte = pd.get_dummies(test[cols], columns=cats, dtype=float)
Xte = Xte.reindex(columns=Xtr.columns, fill_value=0)
model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
model.fit(Xtr, train["win"])
p = model.predict_proba(Xte)[:, 1]
return round(roc_auc_score(test["win"], p), 3), round(log_loss(test["win"], p), 4)
before = ["boat_number", "national_win_rate", "motor_top2_rate", "exhibition_time"]
print("M1 before race", fit_score(train, test, before, ["boat_number"]))
print("M2 + after race", fit_score(train, test, before + ["actual_st", "actual_course"],
["boat_number", "actual_course"]))M1 before race (0.821, 0.3429)
M2 + after race (0.835, 0.3332)左の数字は AUC です。1着の艇と1着でなかった艇を1つずつ取り出したとき、1着の艇のほうに高い点を付けていた割合です。0.5 ならでたらめ、1 なら全部の組で正しい順です。右の数字は log loss で、小さいほど確率の当てはまりが良いという指標です。
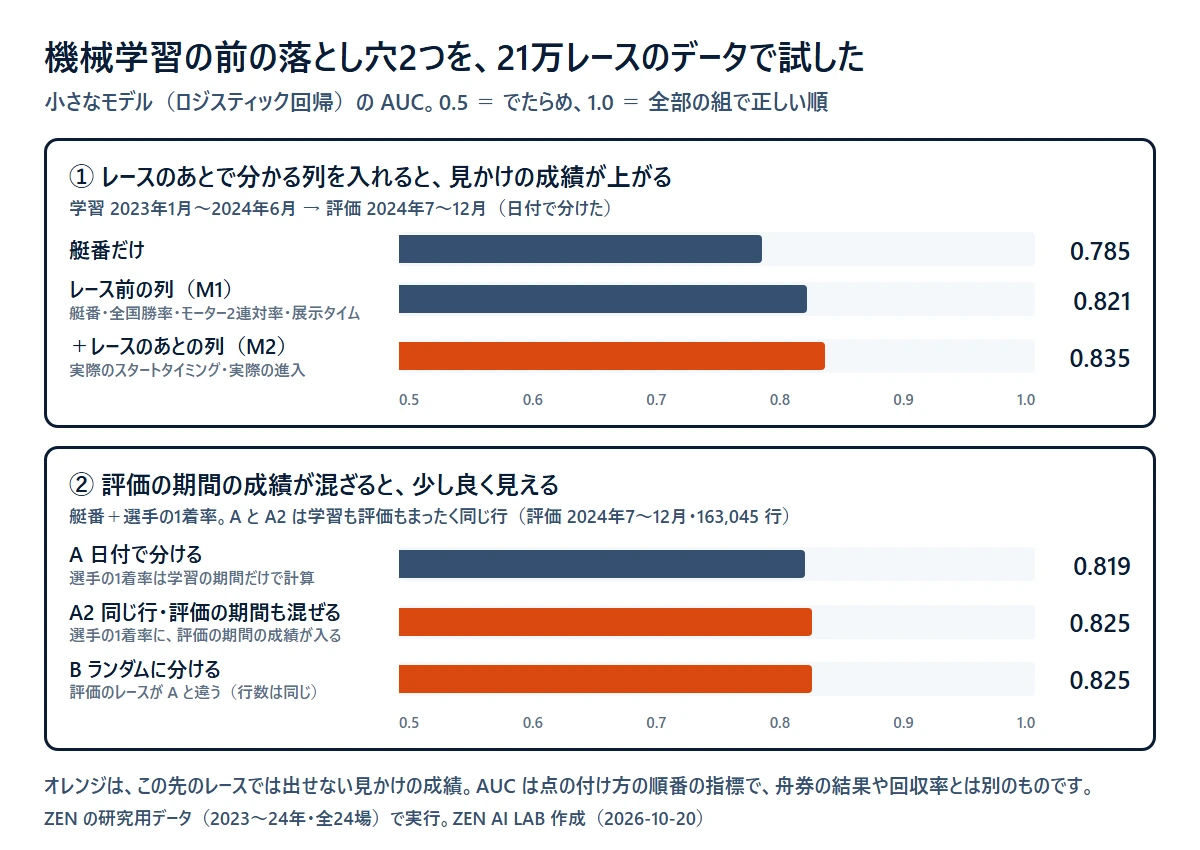
レース前の列だけ(M1)では AUC 0.821、レースのあとの列を足す(M2)と 0.835 に上がりました。 log loss も小さくなっています。
差の大きさより大事なのは、M2 の成績は実際には出せないことです。実際の進入とスタートタイミングは、舟券の締切のあとで決まります。成績が良く見えたら、まずレースのあとの列が入っていないかを疑います。
5. 学習と評価は、ランダムではなく日付で分ける
2つ目の落とし穴は、データの分け方です。
よくある書き方は、全部の行をランダムに分けて、片方で学習、もう片方で評価する方法です。レースのデータでこれをすると、評価するレースより後の日の成績が、学習に入ります。
例として、選手ごとの1着率を特徴量にしました。30走未満の選手は、全体の1着率で埋めます。比べたのは3つです。
- A: 日付で分ける。選手の1着率は、学習の期間(2024年6月まで)だけで計算する
- A2: A と同じ行で学習・評価する。選手の1着率だけ、評価の期間も混ぜて計算する
- B: ランダムに分ける(評価の行数は A と同じ)
from sklearn.model_selection import train_test_split

def add_racer_rate(train, test, min_n=30):
    s = train.groupby("racer")["win"].agg(["mean", "size"])
    rate = s["mean"].where(s["size"] >= min_n)  # 30走未満は使わない
    base = train["win"].mean()
    train = train.assign(racer_rate=train["racer"].map(rate).fillna(base))
    test = test.assign(racer_rate=test["racer"].map(rate).fillna(base))
    return train, test

tr_a, te_a = add_racer_rate(train, test)  # A: 日付で分ける
_, te_a2 = add_racer_rate(d, test)        # A2: 選手の1着率に評価の期間も混ぜる
_, tr_a2 = add_racer_rate(d, train)
tr_b, te_b = train_test_split(d, test_size=len(test) / len(d), random_state=42)
tr_b, te_b = add_racer_rate(tr_b, te_b)   # B: ランダムに分ける
cols = ["boat_number", "racer_rate"]
print("A date  ", fit_score(tr_a, te_a, cols, ["boat_number"]))
print("A2 mixed", fit_score(tr_a2, te_a2, cols, ["boat_number"]))
print("B random", fit_score(tr_b, te_b, cols, ["boat_number"]))
print("A date   boat only", fit_score(tr_a, te_a, ["boat_number"], ["boat_number"]))
print("B random boat only", fit_score(tr_b, te_b, ["boat_number"], ["boat_number"]))
A date (0.819, 0.3442)
A2 mixed (0.825, 0.3403)
B random (0.825, 0.3421)
A date boat only (0.785, 0.3588)
B random boat only (0.787, 0.3606)A と A2 は、学習も評価もまったく同じ行です。違うのは、選手の1着率に評価の期間の成績が混ざっているかだけで、AUC は 0.819 から 0.825 に上がりました。 log loss も小さくなっています。この 0.006 が、評価の期間の成績(そのレース自身の結果も含む)が混ざったことで良く見えた分です。
ランダムに分けた B も 0.825 でした。B では、評価するレースより後の日の同じ選手の成績が、選手の1着率に入ります。ただし B は評価するレースが A と違うので、A との差のすべてが混ざった分とは言えません。艇番だけの形でも、B は A と 0.002 違いました。
どちらにしても、B の数字は「この先のレースでどうか」を測った数字ではありません。この先のレースに近い条件で測ったのは A です。
AUC 0.82 は、舟券の成績とは別の数字
艇番だけの形でも、AUC は 0.785 出ています。1号艇がよく1着になるという、誰でも知っていることを覚えただけで、この数字になります。
AUC は、点の付け方の順番がどれくらい合っているかの指標です。舟券の結果や回収率とは別のものです。この記事のモデルは落とし穴を見せるための例で、予想に使えるとは考えていません。
集めて SQLite にためるところを任せるなら
ZEN AI LAB が作った自社ツールに、BoatData Collector Pro があります。競艇の公開データを、期間と競艇場を選んでまとめて集める Windows 用のツールです。この記事の研究用データベースも、このツールで集めました。
- 集めたデータは SQLite にたまります。取得済みのデータは取り直さず、新しい分だけを取得します
- Excel・CSV にも書き出せます。形は「レースごとに1行」と「艇ごとに1行」の2つです
- データベースには、レース前に分かる列だけのビュー(vw_pre_race_features)が、結果の列と分けて入っています(開発資料とソースコードで確認)
- 開発時の試験では、2026年8月の1か月・24場・4,944レースの取得に390.7秒でした
使う前に知っておいてほしいことです。
- 予想・買い目・自動投票の機能はありません。集めて出力するところまでです
- 公式サイトや BOATRACE とは関係のない、非公式のツールです。データの正確性は保証していません
- 無料版があります。販売ページの説明では、取得できる期間は直近30日までです。製品版は期間を自分で選べます(保存できるのは2016年10月1日以降のレース。2026年11月に実際に取得して確かめた範囲)
- オッズも取得できますが、初期設定ではオフです
くわしくはBoatData Collector Pro 無料版のページと、BoatData Collector Pro のページにあります。自分で取得の仕組みを作る場合の注意は、競艇のデータをAPIで取得するときの注意にまとめました。
競艇のデータを、何か月分も自分で集めて数えるなら
BoatData Collector Pro は、競艇の公開データを期間と競艇場を選んで集め、Excel・CSV に書き出す自社ツールです。予想や買い目は出しません。保存できるのは2016年10月1日以降のレースです。
- BoatData Collector Pro:6,000円(買い切り・note。ココナラでも6,000円)
- 分析版 BOAT DATA PRO:10,000円(ココナラ)。集めたデータを進入コース別・選手別などに集計する画面つき
- 無料版:直近30日まで(LINEで受け取り)
価格は2026年11月7日の表示です。変わることがあるので、買う前に各ページで確かめてください。Windows 11(64bit)用です。
確かめたことと、データでは分からないこと
確かめたことは、次のとおりです。
- 記事のコードは、1つのファイルにまとめて研究用データベースで上から順に実行しました。記事のコードと出力は、そのファイルとその出力から一字一句写したものです
- 同じファイルを2回実行して、出力が同じになることも確かめました。A2 を足したあとにもう1回実行し、ほかの出力が変わらないことを確かめました
- データベースは、読み取り専用(mode=ro)で開きました
- 結果を数えたのは2023〜24年だけです。2025年は研究の確認用に、2026年は最後の確認用に残してあり、件数だけを数えました
- 54.6%・109,188レースは、無料の公開記事と同じ値です
- 風速の比較(110,758レース)は、日付だけで絞りました。1号艇の集計と条件が違うので、件数も違います
- 気象の列がレース時の記録であることは、出力の列の定義とデータベースのビューで確かめました
- 保存先の場所は、保存先の設定のソースコードで確かめました。販売中の版の写しでも、同じ表とビューが定義されていました
- 販売ページ2つは、2026年10月20日に開いて読みました
このデータでは分からないことは、次のとおりです。
- まだ確かめられていないこと:アプリで集めた自分のデータベースを、実際にそのフォルダで開いてはいません。保存先は、ソースコードから読んだ場所です。設定で保存先を変えている場合は、その場所になります
- まだ確かめられていないこと:機械学習の例は、1つのモデル・1つの分け方・seed 42 の1回だけです。特徴量の欠けた62行は除きました。ほかの設定で同じ差が出るかは試していません
- モデルの数字が、この先のレースでも同じになるかは分かりません
- まだ確かめられていないこと:CSV からの実行は試していません
まとめ
競艇のデータ分析は、SQLite を読み取り専用で開き、SQL で1行=1艇にして groupby で数えれば始められます。
mode=roで開き、表ごとの件数と期間を先に見ます- 1号艇の1着率は、何を分母に入れたかを決めてから数えます。場・月は groupby の列を変えるだけです
- 機械学習では、実際の進入・実際のスタートタイミング・着順・レース時の気象を外し、前の期間で学習して後の期間で評価します
次にやることは2つです。
- 自分のデータベースで1節目のコードを動かし、件数と期間を確かめます
- 3節目の
print(by_venue)で、よく買う場の1号艇の1着率を自分の画面で見ます
エクセルでも同じ集計をしたい方は、競艇のデータ分析をエクセルでへどうぞ。
[…] 競艇のデータ分析をPythonで: 21万レースのSQLiteをpandasで読み、1号艇の1着率を出すコードと、機械学習の前に外す列・日付で分ける理由が分かる […]
[…] Python でデータを扱うときの「1着率」と「全国勝率」の違いは、競艇のデータ分析をPythonでにも書いています。 […]